Experimento · Prototipo
Listas de colegios de toda España, con su nivel de fiabilidad
Recorre las webs de 950 colegios para encontrar dónde publica cada uno su lista de libros del curso y deja cada dato con una etiqueta de lo seguro que es.
Cómo se ve
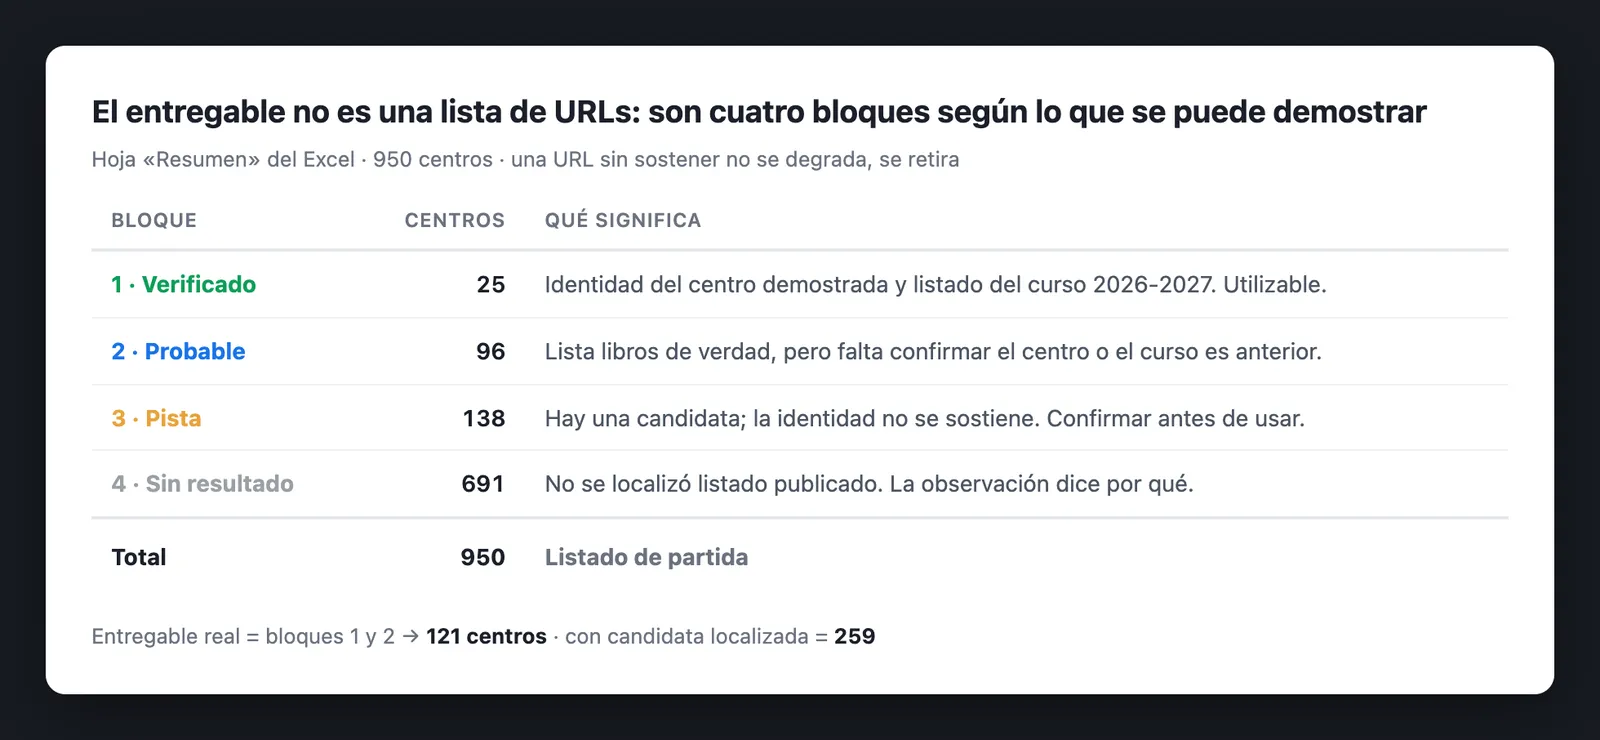
Cuatro bloques según lo que se puede demostrar 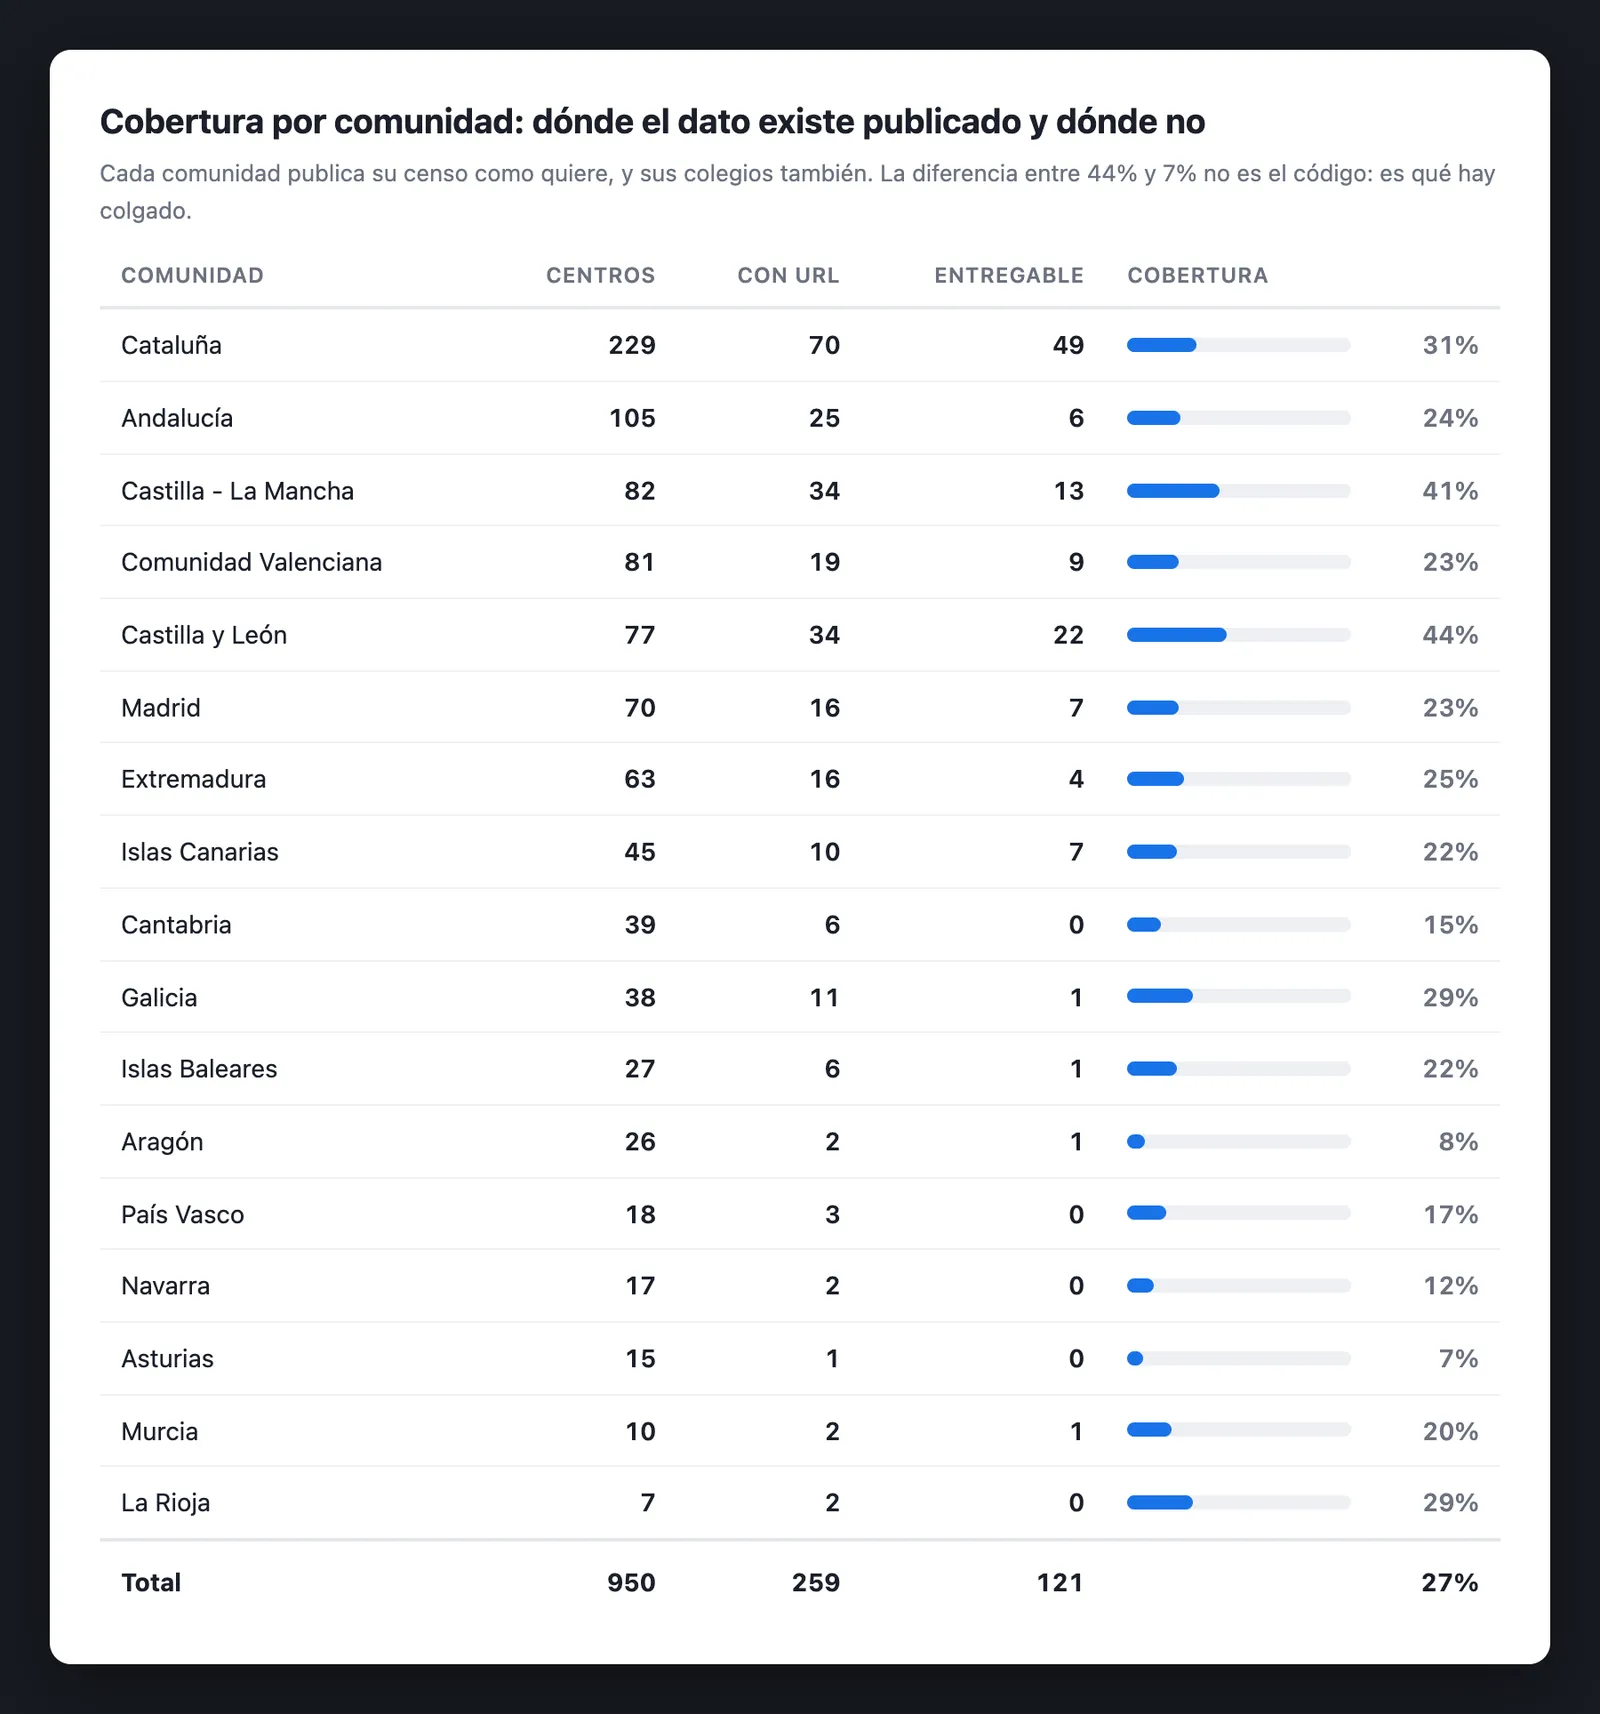
Dónde el dato existe publicado y dónde no, por comunidad
Qué problema resuelve
El censo oficial de centros se descarga en diez minutos, pero la página donde cada colegio cuelga la lista de libros solo la sabe el colegio, y cada uno la publica a su manera: tabla, PDF, foto del papel, documento compartido. Ya no es una tarde de copiar y pegar, es un mes.
Cómo funciona
- 01
Dos datos oficiales, un tercero a buscar
El nombre y el código de cada colegio salen de los datos abiertos de cada comunidad. La dirección del listado de libros no está en ningún registro: hay que entrar colegio por colegio.
- 02
Un rastreador y un buscador solo si hace falta
Un rastreador recorre las webs y descarga los documentos. Solo en los casos en que se queda sin pista se recurre a un buscador, con un límite mensual para no pasarse de gasto.
- 03
Lo que no se puede demostrar, no se entrega
Cada resultado se clasifica en verificado, probable, pista o sin resultado. Una dirección que no se sostiene no se degrada a «probable»: se retira.
- 04
Todo lo descargado se guarda
Lo bajado es la prueba, y el análisis se puede volver a lanzar contra el disco sin repetir el recorrido.
Cómo funciona
Para cada colegio se parte de su código oficial y de su web. Un rastreador recorre la web, sigue los enlaces con más pinta de llevar a la lista de libros y descarga lo que encuentra, en cualquier formato: tabla web, PDF, PDF escaneado, documento compartido. Si se queda sin pista, un buscador web hace una consulta dirigida; es el último recurso, no el primero. Después, un conjunto de reglas decide a qué bloque va cada resultado.
El «stack» es el conjunto de herramientas con las que está hecho. Scrapling es la herramienta de código abierto que recorre las webs; pdfplumber lee los PDF; los datos abiertos de cada comunidad dan el nombre y el código; una caché en disco guarda todo lo descargado, porque lo bajado es la prueba y el análisis se puede repetir sin volver a pedir nada a ninguna web.
Qué medimos y qué aprendimos
Un sistema que se valida a sí mismo se aprueba siempre. El buscador y el validador compartían criterio, así que todo lo que encontraba le parecía bien. Hizo falta un revisor independiente que abriera páginas a mano: el sistema decía ir fino y acertaba el 32 %. No hay atajo: alguien tiene que abrir las páginas y mirarlas.
Mide también lo que tiras. Las cinco auditorías medían la precisión de lo que pasaba el filtro y ninguna miraba lo que el filtro descartaba. Ahí estaba el fallo: para descartar páginas privadas se buscaba una marca de campo de contraseña en el código, y la marca aparecía en la hoja de estilos de un gestor de contenidos muy común, en una línea sobre cómo se pinta el foco de un campo. Cualquier colegio con esa plataforma se tiraba antes de mirar si publicaba libros. Corregido, y volviendo a procesar desde la caché sin una sola consulta nueva, los centros entregables pasaron de 81 a 121.
Los colegios copian la página del curso anterior y le cambian los números. Si el listado de este curso está en una dirección con «curso 2025-26», el del siguiente suele estar en la misma ruta con «26-27». Probarlo cuesta una petición y cero euros de buscador. La pega: hay que cambiar todas las apariciones a la vez, y saber distinguir un curso de un rango («2018-2024» no es un curso).
Cambiar de proveedor no dolió porque la caché guarda el título y la dirección, no la respuesta del proveedor. Las 1.257 búsquedas ya hechas con el primero siguieron valiendo con el segundo, que además admite muchas más consultas por segundo: la pasada bajó de casi tres horas a cinco minutos.
Límites honestos
- Solo 121 de los 950 centros llegan como resultado fiable. El resto son candidatas o no tienen resultado, y se anota por qué: la cobertura es parcial y esa es la cifra honesta.
- El dato existe publicado de forma desigual según la comunidad, y en algunas no hay nada que encontrar.
- Los datos son públicos, pero conviene revisar los términos de uso de cada web antes de repetir un rastreo a gran escala.
- Está aparcado: funciona, pero no se mantiene.
Con qué está hecho
- Python
- Scrapling (rastreo de webs)
- pdfplumber (lectura de PDF)
- API de un buscador web
- Datos abiertos de cada comunidad
- Caché en disco
- Llavero del sistema para la clave
Qué hicimos
- 33.766 páginas y 202 documentos descargados.
- Entregable real: 121 centros entre los verificados y los probables; 259 con una candidata localizada; 691 sin resultado, con la observación de por qué.
- 14 reglas de validación y 74 comprobaciones automáticas, cada una nacida de un fallo real.
- Todo el barrido costó 885 consultas de las 1.000 gratuitas que da el buscador cada mes: coste externo cero.
- Un revisor independiente abrió 25 páginas a mano y el sistema acertaba solo el 32 %. Tras cinco rondas, cada fallo convertido en regla con su prueba, el tramo que se entrega llegó al 94 %.
- Aparcado, pero funcionando.
Qué no entraba
- Dar por buena una dirección que no se puede demostrar.
¿Tienes un proyecto parecido?
Cuéntanos qué necesitas y te decimos cómo lo haríamos y si te sale a cuenta.
Hablemos